| title | Java 线程池详解 | |||||||
|---|---|---|---|---|---|---|---|---|
| description | Java线程池详解:深入讲解ThreadPoolExecutor核心参数配置、Executor框架体系、任务队列选择、拒绝策略、线程池工作原理及最佳实践。 | |||||||
| category | Java | |||||||
| tag |
|
|||||||
| head |
|
池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、HTTP 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
这篇文章我会详细介绍一下线程池的基本概念以及核心原理。
池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、HTTP 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
线程池提供了一种限制和管理资源(包括执行一个任务)的方式。 每个线程池还维护一些基本统计信息,例如已完成任务的数量。使用线程池主要带来以下几个好处:
- 降低资源消耗:线程池里的线程是可以重复利用的。一旦线程完成了某个任务,它不会立即销毁,而是回到池子里等待下一个任务。这就避免了频繁创建和销毁线程带来的开销。
- 提高响应速度:因为线程池里通常会维护一定数量的核心线程(或者说“常驻工人”),任务来了之后,可以直接交给这些已经存在的、空闲的线程去执行,省去了创建线程的时间,任务能够更快地得到处理。
- 提高线程的可管理性:线程池允许我们统一管理池中的线程。我们可以配置线程池的大小(核心线程数、最大线程数)、任务队列的类型和大小、拒绝策略等。这样就能控制并发线程的总量,防止资源耗尽,保证系统的稳定性。同时,线程池通常也提供了监控接口,方便我们了解线程池的运行状态(比如有多少活跃线程、多少任务在排队等),便于调优。
Executor 框架是 Java5 之后引进的,在 Java 5 之后,通过 Executor 来启动线程比使用 Thread 的 start 方法更好,除了更易管理,效率更好(用线程池实现,节约开销)外,还有关键的一点:有助于避免 this 逃逸问题。
this 逃逸是指在构造函数返回之前其他线程就持有该对象的引用,调用尚未构造完全的对象的方法可能引发令人疑惑的错误。
Executor 框架不仅包括了线程池的管理,还提供了线程工厂、队列以及拒绝策略等,Executor 框架让并发编程变得更加简单。
Executor 框架结构主要由三大部分组成:
1、任务(Runnable /Callable)
执行任务需要实现的 Runnable 接口 或 Callable 接口。Runnable 接口或 Callable 接口 实现类都可以被 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。
2、任务的执行(Executor)
如下图所示,包括任务执行机制的核心接口 Executor,以及继承自 Executor 接口的 ExecutorService 接口。ThreadPoolExecutor 和 ScheduledThreadPoolExecutor 这两个关键类实现了 ExecutorService 接口。
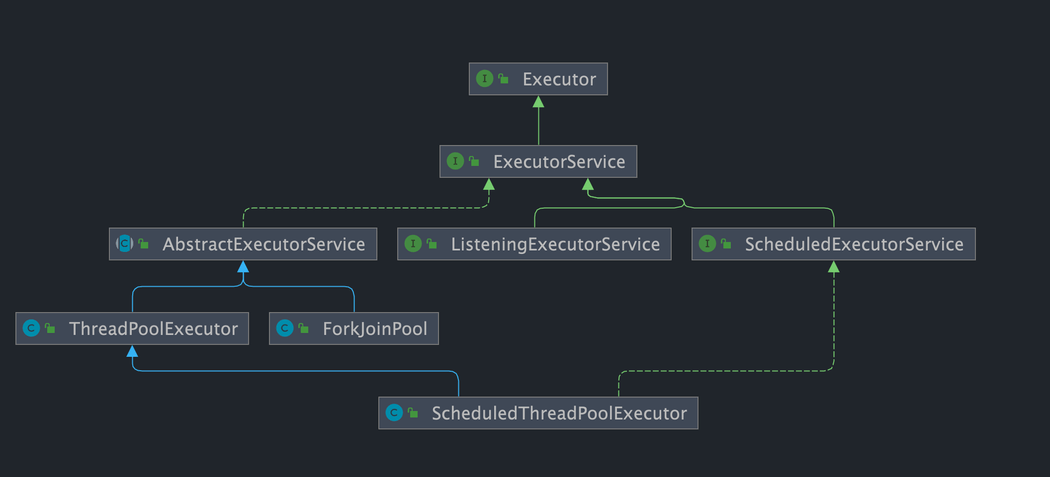
这里提了很多底层的类关系,但是,实际上我们需要更多关注的是 ThreadPoolExecutor 这个类,这个类在我们实际使用线程池的过程中,使用频率还是非常高的。
注意: 通过查看 ScheduledThreadPoolExecutor 源代码我们发现 ScheduledThreadPoolExecutor 实际上是继承了 ThreadPoolExecutor 并实现了 ScheduledExecutorService,而 ScheduledExecutorService 又实现了 ExecutorService,正如我们上面给出的类关系图显示的一样。
ThreadPoolExecutor 类描述:
//AbstractExecutorService实现了ExecutorService接口
public class ThreadPoolExecutor extends AbstractExecutorService
ScheduledThreadPoolExecutor 类描述:
//ScheduledExecutorService继承ExecutorService接口
public class ScheduledThreadPoolExecutor
        extends ThreadPoolExecutor
implements ScheduledExecutorService3、异步计算的结果(Future)
Future 接口以及 Future 接口的实现类 FutureTask 类都可以代表异步计算的结果。
当我们把 Runnable 接口 或 Callable 接口 的实现类提交给 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行时,调用 submit() 会返回一个实现了 Future 接口的对象。具体实现不一定是 FutureTask,例如定时线程池会返回相应的 RunnableScheduledFuture 实现。
Executor 框架的使用示意图:

- 主线程首先要创建实现
Runnable或者Callable接口的任务对象。 - 把创建完成的实现
Runnable/Callable接口的 对象直接交给ExecutorService执行:ExecutorService.execute(Runnable command))或者也可以把Runnable对象或Callable对象提交给ExecutorService执行(ExecutorService.submit(Runnable task)或ExecutorService.submit(Callable <T> task))。 - 如果执行
ExecutorService.submit(...),ExecutorService将返回一个实现Future接口的对象。由于FutureTask同时实现了Runnable和Future,我们也可以自行创建FutureTask,然后直接交给ExecutorService执行。 - 最后,主线程可以执行
Future.get()方法来等待任务执行完成,也可以执行Future.cancel(boolean mayInterruptIfRunning)来尝试取消任务。
线程池实现类 ThreadPoolExecutor 是 Executor 框架最核心的类。
ThreadPoolExecutor 类中提供的四个构造方法。我们来看最长的那个,其余三个都是在这个构造方法的基础上产生(其他几个构造方法说白点都是给定某些默认参数的构造方法比如默认制定拒绝策略是什么)。
    /**
     * 用给定的初始参数创建一个新的ThreadPoolExecutor。
     */
    public ThreadPoolExecutor(int corePoolSize,//线程池的核心线程数量
                              int maximumPoolSize,//线程池的最大线程数
                              long keepAliveTime,//当线程数大于核心线程数时,多余的空闲线程存活的最长时间
                              TimeUnit unit,//时间单位
                              BlockingQueue<Runnable> workQueue,//任务队列,用来储存等待执行任务的队列
                              ThreadFactory threadFactory,//线程工厂,用来创建线程,一般默认即可
                              RejectedExecutionHandler handler//拒绝策略,当提交的任务过多而不能及时处理时,我们可以定制策略来处理任务
                               ) {
        if (corePoolSize < 0 ||
            maximumPoolSize <= 0 ||
            maximumPoolSize < corePoolSize ||
            keepAliveTime < 0)
            throw new IllegalArgumentException();
        if (workQueue == null || threadFactory == null || handler == null)
            throw new NullPointerException();
        this.corePoolSize = corePoolSize;
        this.maximumPoolSize = maximumPoolSize;
        this.workQueue = workQueue;
        this.keepAliveTime = unit.toNanos(keepAliveTime);
        this.threadFactory = threadFactory;
        this.handler = handler;
    }
下面这些参数非常重要,在后面使用线程池的过程中你一定会用到!所以,务必拿着小本本记清楚。
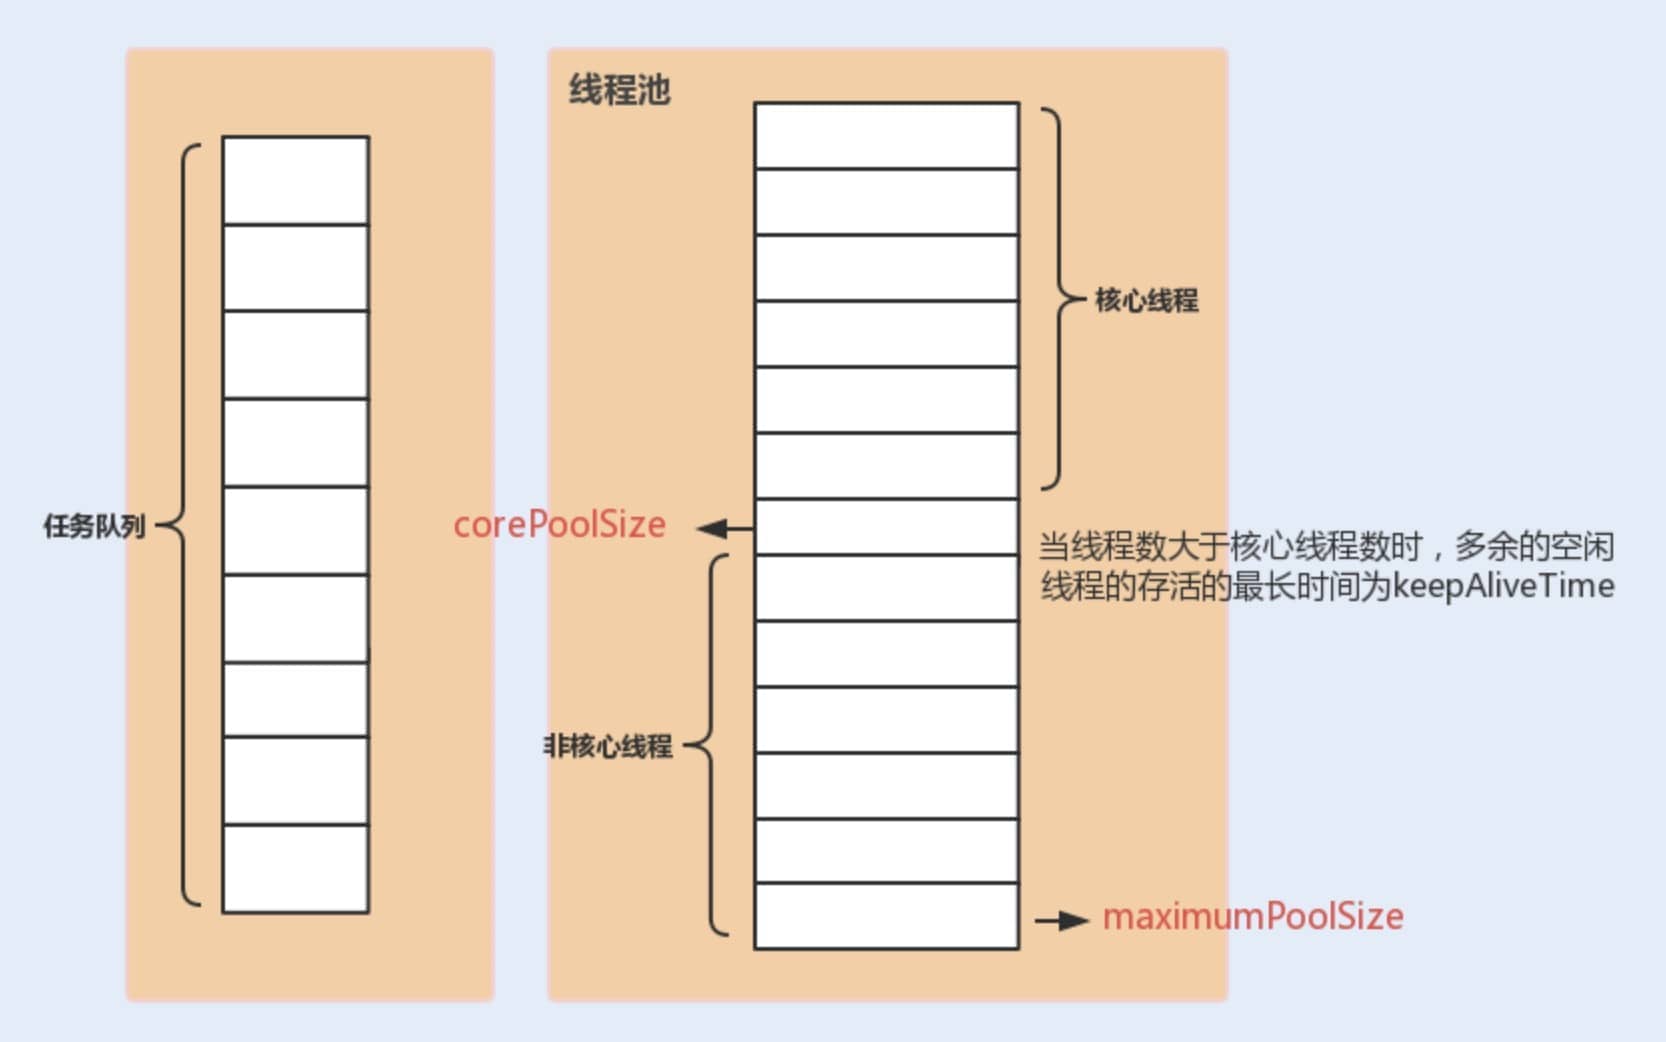
ThreadPoolExecutor 3 个最重要的参数:
corePoolSize:线程池优先维持的工作线程数量。默认情况下线程按需创建;工作线程数达到该值后,新任务通常先进入队列。maximumPoolSize: 任务队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。workQueue: 新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
ThreadPoolExecutor 其他常见参数 :
keepAliveTime:线程池中的线程数量大于corePoolSize的时候,如果这时没有新的任务提交,核心线程外的线程不会立即销毁,而是会等待,直到等待的时间超过了keepAliveTime才会被回收销毁。unit:keepAliveTime参数的时间单位。threadFactory:executor 创建新线程的时候会用到。handler:拒绝策略(后面会单独详细介绍一下)。
下面这张图可以加深你对线程池中各个参数的相互关系的理解(图片来源:《Java 性能调优实战》):
ThreadPoolExecutor 使用 ctl 变量(AtomicInteger 类型)同时管理线程池的运行状态和工作线程数量。线程池共有 5 种状态:
- 运行中(
RUNNING):接受新任务,并处理队列中的任务。线程池创建后的初始状态。 - 关闭(
SHUTDOWN):不再接受新任务,但会继续处理队列中已有的任务。调用shutdown()后进入。 - 停止(
STOP):不接受新任务,不处理队列中的任务,并尝试中断正在执行的任务。调用shutdownNow()后进入。 - 整理中(
TIDYING):所有任务已终止,工作线程数为 0,即将执行terminated()钩子方法。 - 已终止(
TERMINATED):terminated()方法执行完毕,线程池彻底终结。
状态只能单向流转:运行中(RUNNING)→ 关闭(SHUTDOWN)→ 整理中(TIDYING)→ 已终止(TERMINATED),或者运行中(RUNNING)→ 停止(STOP)→ 整理中(TIDYING)→ 已终止(TERMINATED)。在关闭(SHUTDOWN)状态下再调用 shutdownNow() 也会转为停止(STOP)。
shutdown() 是“温和关闭”——中断空闲线程,但队列中的任务仍会执行完毕。shutdownNow() 是“强制关闭”——尝试中断所有正在运行的线程,并将队列中未执行的任务以 List<Runnable> 返回。terminated() 是一个空的钩子方法,可以通过继承 ThreadPoolExecutor 来重写它,用于在线程池终止后做清理工作。
ThreadPoolExecutor 将每个工作线程封装为内部类 Worker。Worker 继承了 AQS 并实现了 Runnable 接口。
为什么 Worker 要继承 AQS? Worker 实现了一个不可重入的独占锁,用于配合 shutdown() 区分线程是空闲还是正在工作——正在执行任务的 Worker 持有锁,shutdown() 对每个 Worker 尝试 tryLock(),失败则说明该线程正在工作,不会被中断。
Worker 的生命周期:
- 创建:
execute()判断需要新建线程时,调用addWorker()创建Worker实例,内部通过ThreadFactory创建线程。 - 运行:线程启动后进入
runWorker()的while循环,通过getTask()不断从队列取任务执行。Worker 并不会被永久标记为“核心”或“非核心”;当允许核心线程超时,或者当前工作线程数大于corePoolSize时,getTask()才会使用带超时的workQueue.poll(keepAliveTime, unit),否则使用workQueue.take()阻塞等待。 - 退出:
getTask()返回null时 Worker 退出循环并清理。返回null的情况包括:线程池处于停止(STOP)状态、线程池处于关闭(SHUTDOWN)状态且队列为空、非核心线程等待超时、或运行时缩小了maximumPoolSize。如果退出后工作线程数低于核心数,会自动补充一个新线程。
ThreadPoolExecutor 拒绝策略定义:
当线程池已经关闭,或者当前工作线程数达到上限且队列也无法接收新任务时,ThreadPoolExecutor 会调用拒绝策略:
ThreadPoolExecutor.AbortPolicy:抛出RejectedExecutionException来拒绝新任务的处理。ThreadPoolExecutor.CallerRunsPolicy:调用执行自己的线程运行任务,也就是直接在调用execute方法的线程中运行(run)被拒绝的任务,如果执行程序已关闭,则会丢弃该任务。因此这种策略会降低对于新任务提交速度,影响程序的整体性能。如果您的应用程序可以承受此延迟并且你要求任何一个任务请求都要被执行的话,你可以选择这个策略。ThreadPoolExecutor.DiscardPolicy:不处理新任务,直接丢弃掉。ThreadPoolExecutor.DiscardOldestPolicy:此策略将丢弃最早的未处理的任务请求。
举个例子:
举个例子:Spring 通过 ThreadPoolTaskExecutor 或者我们直接通过 ThreadPoolExecutor 的构造函数创建线程池的时候,当我们不指定 RejectedExecutionHandler 拒绝策略来配置线程池的时候,默认使用的是 AbortPolicy。在这种拒绝策略下,如果队列满了,ThreadPoolExecutor 将抛出 RejectedExecutionException 异常来拒绝新来的任务,这代表你将丢失对这个任务的处理。在线程池仍处于运行状态时,CallerRunsPolicy 会将被拒绝的任务交给调用者线程执行;线程池已经关闭时,该策略会直接丢弃任务。
public static class CallerRunsPolicy implements RejectedExecutionHandler {

        public CallerRunsPolicy() { }

        public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
            if (!e.isShutdown()) {
                // 直接主线程执行,而不是线程池中的线程执行
                r.run();
            }
        }
}上面介绍了 4 种内置拒绝策略的基本行为,下面结合实际生产经验,说明它们各自适合什么场景:
AbortPolicy:适用于对任务丢失零容忍的核心业务(如支付、转账)。任务被拒绝时调用方会收到 RejectedExecutionException,必须在业务代码中捕获并做补偿(如重试或持久化到数据库后补偿执行)。《阿里巴巴 Java 开发手册》指出,如果不做任何配置,队列满时会直接抛异常,开发者必须显式处理。
CallerRunsPolicy:适用于不允许丢弃任务、且允许降低提交速度的场景。由于任务在调用者线程中执行,调用者在此期间无法提交新任务,形成了一种天然的**反压(back-pressure)**机制。美团技术团队在《Java 线程池实现原理及其在美团业务中的实践》中提到,这是他们线上业务中较常使用的拒绝策略。但需要注意:如果提交任务的线程是 Web 容器的请求处理线程(如 Tomcat 的 Worker 线程),会导致该请求响应时间显著增加,在延迟敏感的场景中需谨慎。
DiscardPolicy:适用于任务允许丢失的非关键路径,如日志异步写入、监控指标上报。该策略完全静默(空实现),被拒绝的任务不会留下任何痕迹,排查问题时可能难以发现任务丢失。
DiscardOldestPolicy:适用于只关心最新数据、旧任务可被覆盖的场景,如实时行情推送、传感器数据采集。需要注意:如果使用了 PriorityBlockingQueue,poll() 弹出的是优先级最高的任务而非最旧的任务,可能导致重要任务被误丢。
生产环境中的常见做法:以上 4 种内置策略往往不能完全满足需求。Dubbo 框架自定义了 AbortPolicyWithReport 策略,在抛异常之外还会将被拒绝的任务信息 dump 到本地文件,方便事后排查。美团技术团队建议对线程池的拒绝次数进行监控和告警。常见的自定义策略思路包括:将被拒绝的任务写入数据库或消息队列后续补偿消费、递增监控计数器上报 Prometheus、或者调用 workQueue.put(r) 阻塞等待队列有空位(Netty 中有类似实现)。
在 Java 中,创建线程池主要有两种方式:
方式一:通过 ThreadPoolExecutor 构造函数直接创建(推荐)
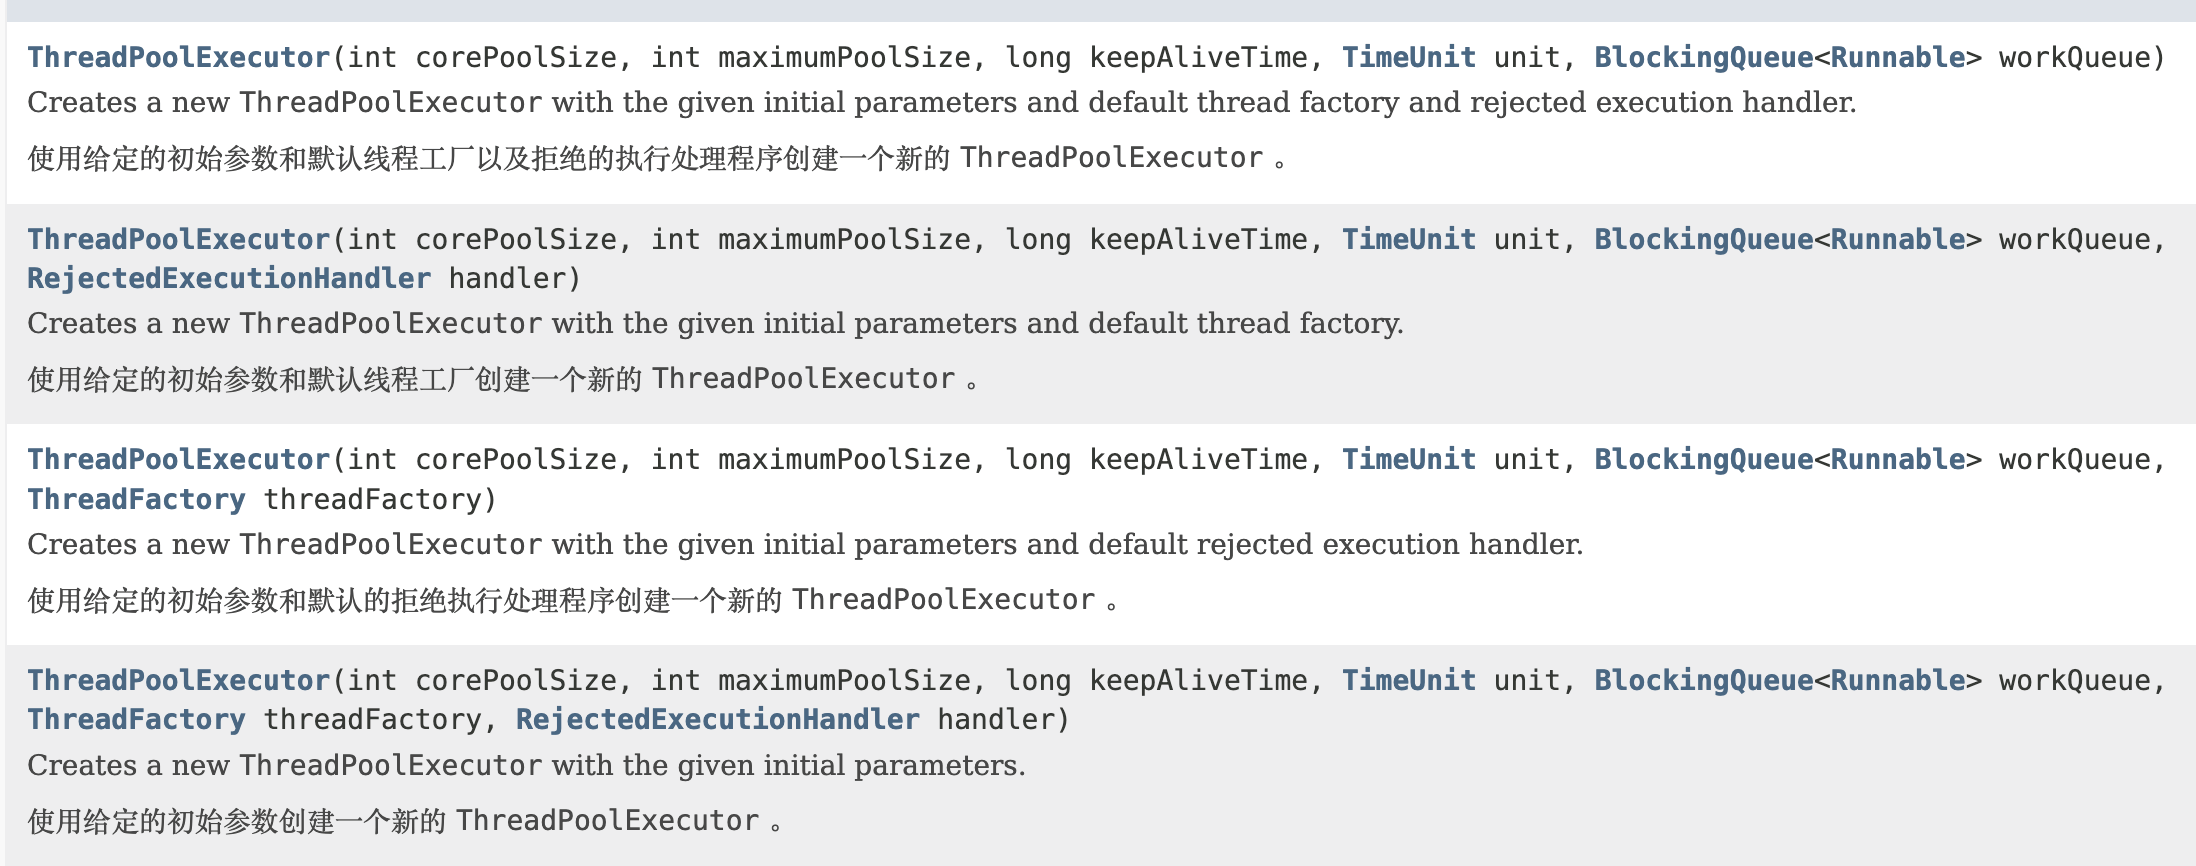
图中的“默认线程工厂”和“默认拒绝策略”,指的是当前构造函数没有显式传入对应参数时,ThreadPoolExecutor 会使用默认实现,并不是方法和说明错位。
这是最推荐的方式,因为它允许开发者明确指定线程池的核心参数,对线程池的运行行为有更精细的控制,从而避免资源耗尽的风险。
方式二:通过 Executors 工具类创建(不推荐用于生产环境)
Executors 工具类提供的创建线程池的方法如下图所示:
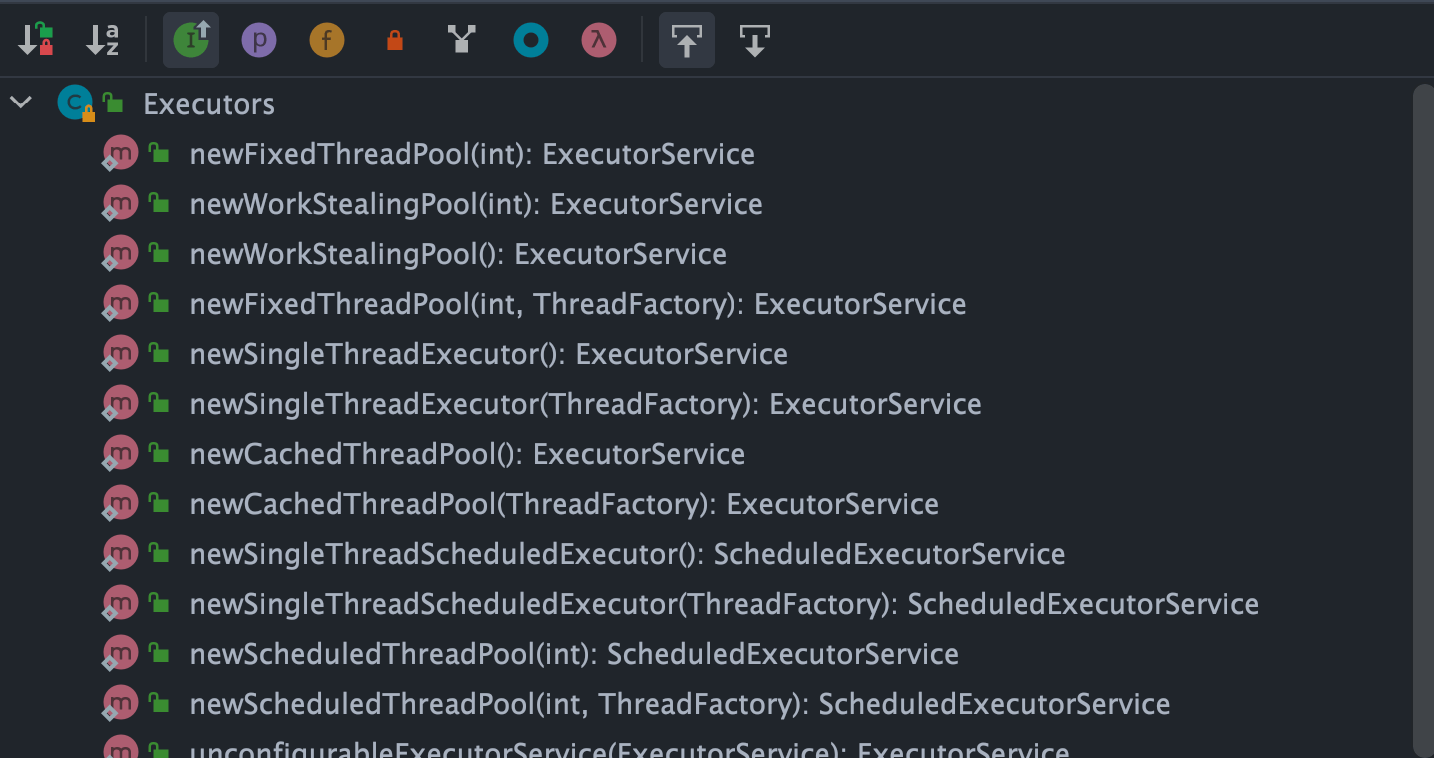
可以看出,通过 Executors 工具类可以创建多种类型的线程池,包括:
FixedThreadPool:正常运行时最多使用固定数量的工作线程。线程可以因异常终止后被替换,线程池关闭时也会退出,因此并非在整个生命周期中数量始终不变。当有一个新的任务提交时,线程池中若有空闲线程,则立即执行。若没有,则新的任务会被暂存在一个任务队列中,待有线程空闲时,便处理在任务队列中的任务。SingleThreadExecutor: 只有一个线程的线程池。若多余一个任务被提交到该线程池,任务会被保存在一个任务队列中,待线程空闲,按先入先出的顺序执行队列中的任务。CachedThreadPool: 可根据实际情况调整线程数量的线程池。线程池的线程数量不确定,但若有空闲线程可以复用,则会优先使用可复用的线程。若所有线程均在工作,又有新的任务提交,则会创建新的线程处理任务。所有线程在当前任务执行完毕后,将返回线程池进行复用。ScheduledThreadPool:给定的延迟后运行任务或者定期执行任务的线程池。
《阿里巴巴 Java 开发手册》强制线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 构造函数的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险
Executors 返回线程池对象的弊端如下(后文会详细介绍到):
FixedThreadPool和SingleThreadExecutor:使用的是阻塞队列LinkedBlockingQueue,任务队列最大长度为Integer.MAX_VALUE,可以看作是无界的,可能堆积大量的请求,从而导致 OOM。CachedThreadPool:使用的是同步队列SynchronousQueue, 允许创建的线程数量为Integer.MAX_VALUE,如果任务数量过多且执行速度较慢,可能会创建大量的线程,从而导致 OOM。ScheduledThreadPool和SingleThreadScheduledExecutor:使用的无界的延迟阻塞队列DelayedWorkQueue,任务队列最大长度为Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。
public static ExecutorService newFixedThreadPool(int nThreads) {
    // LinkedBlockingQueue 的默认长度为 Integer.MAX_VALUE,可以看作是无界的
    return new ThreadPoolExecutor(nThreads, nThreads,0L, TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>());

}

public static ExecutorService newSingleThreadExecutor() {
    // LinkedBlockingQueue 的默认长度为 Integer.MAX_VALUE,可以看作是无界的
    return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1,0L, TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>()));

}

// 同步队列 SynchronousQueue,没有容量,最大线程数是 Integer.MAX_VALUE`
public static ExecutorService newCachedThreadPool() {

    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,60L, TimeUnit.SECONDS,new SynchronousQueue<Runnable>());

}

// DelayedWorkQueue(延迟阻塞队列)
public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) {
    return new ScheduledThreadPoolExecutor(corePoolSize);
}
public ScheduledThreadPoolExecutor(int corePoolSize) {
    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
          new DelayedWorkQueue());
}新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
不同的线程池会选用不同的阻塞队列,我们可以结合内置线程池来分析。
- 容量为
Integer.MAX_VALUE的LinkedBlockingQueue(无界队列):FixedThreadPool和SingleThreadExecutor。FixedThreadPool最多只能创建核心线程数的线程(核心线程数和最大线程数相等),SingleThreadExecutor只能创建一个线程(核心线程数和最大线程数都是 1),二者的任务队列在实际使用中几乎不会被放满。 SynchronousQueue(同步队列):CachedThreadPool。SynchronousQueue没有容量,不存储元素,目的是保证对于提交的任务,如果有空闲线程,则使用空闲线程来处理;否则新建一个线程来处理任务。也就是说,CachedThreadPool的最大线程数是Integer.MAX_VALUE,可以理解为线程数是可以无限扩展的,可能会创建大量线程,从而导致 OOM。DelayedWorkQueue(延迟阻塞队列):ScheduledThreadPool和SingleThreadScheduledExecutor。DelayedWorkQueue的内部元素并不是按照放入的时间排序,而是会按照延迟的时间长短对任务进行排序,内部采用的是“堆”的数据结构,可以保证每次出队的任务都是当前队列中执行时间最靠前的。DelayedWorkQueue添加元素满了之后会自动扩容原来容量的 1/2,即永远不会阻塞,最大扩容可达Integer.MAX_VALUE,所以最多只能创建核心线程数的线程。
我们上面讲解了 Executor 框架以及 ThreadPoolExecutor 类,下面让我们实战一下,来通过写一个 ThreadPoolExecutor 的小 Demo 来回顾上面的内容。
首先创建一个 Runnable 接口的实现类(当然也可以是 Callable 接口,我们后面会介绍两者的区别。)
MyRunnable.java
import java.util.Date;

/**
 * 这是一个简单的Runnable类,需要大约5秒钟来执行其任务。
 * @author shuang.kou
 */
public class MyRunnable implements Runnable {

    private String command;

    public MyRunnable(String s) {
        this.command = s;
    }

    @Override
    public void run() {
        System.out.println(Thread.currentThread().getName() + " Start. Time = " + new Date());
        processCommand();
        System.out.println(Thread.currentThread().getName() + " End. Time = " + new Date());
    }

    private void processCommand() {
        try {
            Thread.sleep(5000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }

    @Override
    public String toString() {
        return this.command;
    }
}
编写测试程序,我们这里以阿里巴巴推荐的使用 ThreadPoolExecutor 构造函数自定义参数的方式来创建线程池。
ThreadPoolExecutorDemo.java
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

public class ThreadPoolExecutorDemo {

    private static final int CORE_POOL_SIZE = 5;
    private static final int MAX_POOL_SIZE = 10;
    private static final int QUEUE_CAPACITY = 100;
    private static final Long KEEP_ALIVE_TIME = 1L;
    public static void main(String[] args) {

        //使用阿里巴巴推荐的创建线程池的方式
        //通过ThreadPoolExecutor构造函数自定义参数创建
        ThreadPoolExecutor executor = new ThreadPoolExecutor(
                CORE_POOL_SIZE,
                MAX_POOL_SIZE,
                KEEP_ALIVE_TIME,
                TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(QUEUE_CAPACITY),
                new ThreadPoolExecutor.CallerRunsPolicy());

        for (int i = 0; i < 10; i++) {
            //创建WorkerThread对象(WorkerThread类实现了Runnable 接口)
            Runnable worker = new MyRunnable("" + i);
            //执行Runnable
            executor.execute(worker);
        }
        //终止线程池
        executor.shutdown();
        while (!executor.isTerminated()) {
        }
        System.out.println("Finished all threads");
    }
}
可以看到我们上面的代码指定了:
corePoolSize: 核心线程数为 5。maximumPoolSize:最大线程数 10keepAliveTime: 等待时间为 1L。unit: 等待时间的单位为 TimeUnit.SECONDS。workQueue:任务队列为ArrayBlockingQueue,并且容量为 100;handler:拒绝策略为CallerRunsPolicy。
输出结构:
pool-1-thread-3 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-5 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-2 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-1 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-4 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-3 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-4 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-1 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-5 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-1 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-2 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-5 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-4 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-3 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-2 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-1 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-4 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-5 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-3 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-2 End. Time = Sun Apr 12 11:14:47 CST 2020
Finished all threads  // 任务全部执行完了才会跳出来,因为executor.isTerminated()判断为true了才会跳出while循环,当且仅当调用 shutdown() 方法后,并且所有提交的任务完成后返回为 true
我们通过前面的代码输出结果可以看出:线程池首先会先执行 5 个任务,然后这些任务有任务被执行完的话,就会去拿新的任务执行。 大家可以先通过上面讲解的内容,分析一下到底是咋回事?(自己独立思考一会)
现在,我们就分析上面的输出内容来简单分析一下线程池原理。
为了搞懂线程池的原理,我们需要首先分析一下 execute 方法。 在示例代码中,我们使用 executor.execute(worker) 来提交一个任务到线程池中去。
这个方法非常重要,下面我们来看看它的源码:
   // 存放线程池的运行状态 (runState) 和线程池内有效线程的数量 (workerCount)
   private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));

    private static int workerCountOf(int c) {
        return c & CAPACITY;
    }
    //任务队列
    private final BlockingQueue<Runnable> workQueue;

    public void execute(Runnable command) {
        // 如果任务为null,则抛出异常。
        if (command == null)
            throw new NullPointerException();
        // ctl 中保存的线程池当前的一些状态信息
        int c = ctl.get();

        //  下面会涉及到 3 步 操作
        // 1.首先判断当前线程池中的工作线程总数是否小于 corePoolSize
        // 如果小于的话,通过addWorker(command, true)新建一个线程,并将任务(command)添加到该线程中;然后,启动该线程从而执行任务。
        if (workerCountOf(c) < corePoolSize) {
            if (addWorker(command, true))
                return;
            c = ctl.get();
        }
        // 2.如果当前工作线程总数大于等于 corePoolSize 的时候就会走到这里,表明没有走核心线程的创建分支。
        // 通过 isRunning 方法判断线程池状态,线程池处于 RUNNING 状态并且队列可以加入任务,该任务才会被加入进去
        if (isRunning(c) && workQueue.offer(command)) {
            int recheck = ctl.get();
            // 再次获取线程池状态,如果线程池状态不是 RUNNING 状态就需要从任务队列中移除任务,并尝试判断线程是否全部执行完毕。同时执行拒绝策略。
            if (!isRunning(recheck) && remove(command))
                reject(command);
                // 如果当前工作线程数量为0,新创建一个线程并执行。
            else if (workerCountOf(recheck) == 0)
                addWorker(null, false);
        }
        //3. 通过addWorker(command, false)新建一个线程,并将任务(command)添加到该线程中;然后,启动该线程从而执行任务。
        // 传入 false 代表增加线程时判断当前线程数是否少于 maxPoolSize
        //如果addWorker(command, false)执行失败,则通过reject()执行相应的拒绝策略的内容。
        else if (!addWorker(command, false))
            reject(command);
    }
这里简单分析一下整个流程(对整个逻辑进行了简化,方便理解):
- 如果当前工作线程总数小于核心线程数,那么就会新建一个线程来执行任务。
- 如果当前工作线程总数已经达到核心线程数,先尝试把任务放入任务队列中等待执行。
- 如果向任务队列投放任务失败(任务队列已经满了),并且当前工作线程总数小于最大线程数,就新建一个非核心线程来执行任务。
- 如果当前工作线程总数已经等同于最大线程数,任务队列也无法继续接收任务,那么当前任务会被拒绝,拒绝策略会调用
RejectedExecutionHandler.rejectedExecution()方法。
补充说明:很多人误以为非核心线程只在任务队列满的时候才会被创建,之后就“闲着”等销毁。实际上,非核心线程执行完初始任务后,并不会立刻销毁,而是会主动从任务队列中拉取任务执行(通过
getTask()方法)。具体来说,核心线程使用workQueue.take()阻塞等待任务,而非核心线程使用workQueue.poll(keepAliveTime, unit)——如果在存活时间内从队列中取到了任务,就会继续执行;只有超时没有取到任务,非核心线程才会被回收。这意味着,即使新任务被放入了队列,空闲的非核心线程也会抢先从队列中取走任务来执行,而不是等队列满了才被动响应。
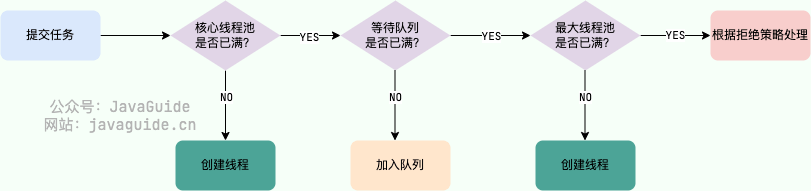
在 execute 方法中,多次调用 addWorker 方法。addWorker 这个方法主要用来创建新的工作线程,如果返回 true 说明创建和启动工作线程成功,否则的话返回的就是 false。
    // 全局锁,并发操作必备
    private final ReentrantLock mainLock = new ReentrantLock();
    // 跟踪线程池的最大大小,只有在持有全局锁mainLock的前提下才能访问此集合
    private int largestPoolSize;
    // 工作线程集合,存放线程池中所有的(活跃的)工作线程,只有在持有全局锁mainLock的前提下才能访问此集合
    private final HashSet<Worker> workers = new HashSet<>();
    //获取线程池状态
    private static int runStateOf(int c)     { return c & ~CAPACITY; }
    //判断线程池的状态是否为 Running
    private static boolean isRunning(int c) {
        return c < SHUTDOWN;
    }


    /**
     * 添加新的工作线程到线程池
     * @param firstTask 要执行
     * @param core参数为true的话表示使用线程池的基本大小,为false使用线程池最大大小
     * @return 添加成功就返回true否则返回false
     */
   private boolean addWorker(Runnable firstTask, boolean core) {
        retry:
        for (;;) {
            //这两句用来获取线程池的状态
            int c = ctl.get();
            int rs = runStateOf(c);

            // Check if queue empty only if necessary.
            if (rs >= SHUTDOWN &&
                ! (rs == SHUTDOWN &&
                   firstTask == null &&
                   ! workQueue.isEmpty()))
                return false;

            for (;;) {
               //获取线程池中工作的线程的数量
                int wc = workerCountOf(c);
                // core参数为false的话表明队列也满了,线程池大小变为 maximumPoolSize
                if (wc >= CAPACITY ||
                    wc >= (core ? corePoolSize : maximumPoolSize))
                    return false;
               //原子操作将workcount的数量加1
                if (compareAndIncrementWorkerCount(c))
                    break retry;
                // 如果线程的状态改变了就再次执行上述操作
                c = ctl.get();
                if (runStateOf(c) != rs)
                    continue retry;
                // else CAS failed due to workerCount change; retry inner loop
            }
        }
        // 标记工作线程是否启动成功
        boolean workerStarted = false;
        // 标记工作线程是否创建成功
        boolean workerAdded = false;
        Worker w = null;
        try {

            w = new Worker(firstTask);
            final Thread t = w.thread;
            if (t != null) {
              // 加锁
                final ReentrantLock mainLock = this.mainLock;
                mainLock.lock();
                try {
                   //获取线程池状态
                    int rs = runStateOf(ctl.get());
                   //rs < SHUTDOWN 如果线程池状态依然为RUNNING,并且线程的状态是存活的话,就会将工作线程添加到工作线程集合中
                  //(rs=SHUTDOWN && firstTask == null)如果线程池状态小于STOP,也就是RUNNING或者SHUTDOWN状态下,同时传入的任务实例firstTask为null,则需要添加到工作线程集合和启动新的Worker
                   // firstTask == null证明只新建线程而不执行任务
                    if (rs < SHUTDOWN ||
                        (rs == SHUTDOWN && firstTask == null)) {
                        if (t.isAlive()) // precheck that t is startable
                            throw new IllegalThreadStateException();
                        workers.add(w);
                       //更新当前工作线程的最大容量
                        int s = workers.size();
                        if (s > largestPoolSize)
                            largestPoolSize = s;
                      // 工作线程是否启动成功
                        workerAdded = true;
                    }
                } finally {
                    // 释放锁
                    mainLock.unlock();
                }
                //// 如果成功添加工作线程,则调用Worker内部的线程实例t的Thread#start()方法启动真实的线程实例
                if (workerAdded) {
                    t.start();
                  /// 标记线程启动成功
                    workerStarted = true;
                }
            }
        } finally {
           // 线程启动失败,需要从工作线程中移除对应的Worker
            if (! workerStarted)
                addWorkerFailed(w);
        }
        return workerStarted;
}更多关于线程池源码分析的内容推荐这篇文章:硬核干货:4W 字从源码上分析 JUC 线程池 ThreadPoolExecutor 的实现原理。
现在,让我们在回到示例代码, 现在应该是不是很容易就可以搞懂它的原理了呢?
没搞懂的话,也没关系,可以看看我的分析:
我们在代码中模拟了 10 个任务,我们配置的核心线程数为 5、等待队列容量为 100,所以每次只可能存在 5 个任务同时执行,剩下的 5 个任务会被放到等待队列中去。当前的 5 个任务中如果有任务被执行完了,线程池就会去拿新的任务执行。
Runnable 自 Java 1.0 以来一直存在,但 Callable 仅在 Java 1.5 中引入,目的就是为了来处理 Runnable 不支持的用例。Runnable 接口不会返回结果或抛出检查异常,但是 Callable 接口可以。所以,如果任务不需要返回结果或抛出异常推荐使用 Runnable 接口,这样代码看起来会更加简洁。
工具类 Executors 可以实现将 Runnable 对象转换成 Callable 对象。(Executors.callable(Runnable task) 或 Executors.callable(Runnable task, Object result))。
Runnable.java
@FunctionalInterface
public interface Runnable {
   /**
    * 被线程执行,没有返回值也无法抛出异常
    */
    public abstract void run();
}
Callable.java
@FunctionalInterface
public interface Callable<V> {
    /**
     * 计算结果,或在无法这样做时抛出异常。
     * @return 计算得出的结果
     * @throws 如果无法计算结果,则抛出异常
     */
    V call() throws Exception;
}
execute() 和 submit() 是两种提交任务到线程池的方法,有一些区别:
- 返回值:
execute()方法用于提交不需要返回值的Runnable任务。submit()可以提交Runnable或Callable任务,并返回一个Future对象。Future.isDone()只能说明任务已经以正常完成、异常或取消中的某种状态结束;调用get()才能取得结果,或者获知任务抛出的异常(get(long timeout, TimeUnit unit)在超时前未完成时会抛出TimeoutException)。 - 异常处理:在使用
submit()方法时,可以通过Future对象处理任务执行过程中抛出的异常;而在使用execute()方法时,异常处理需要通过自定义的ThreadFactory(在线程工厂创建线程的时候设置UncaughtExceptionHandler对象来 处理异常)或ThreadPoolExecutor的afterExecute()方法来处理
示例 1:使用 get() 方法获取返回值。
// 这里只是为了演示使用,推荐使用 `ThreadPoolExecutor` 构造方法来创建线程池。
ExecutorService executorService = Executors.newFixedThreadPool(3);

Future<String> submit = executorService.submit(() -> {
    try {
        Thread.sleep(5000L);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
    return "abc";
});

String s = submit.get();
System.out.println(s);
executorService.shutdown();
输出:
abc
示例 2:使用 get(long timeout,TimeUnit unit) 方法获取返回值。
ExecutorService executorService = Executors.newFixedThreadPool(3);

Future<String> submit = executorService.submit(() -> {
    try {
        Thread.sleep(5000L);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
    return "abc";
});

String s = submit.get(3, TimeUnit.SECONDS);
System.out.println(s);
executorService.shutdown();
输出:
Exception in thread "main" java.util.concurrent.TimeoutException
  at java.util.concurrent.FutureTask.get(FutureTask.java:205)
shutdown():关闭线程池,线程池的状态变为SHUTDOWN。线程池不再接受新任务了,但是队列里的任务得执行完毕。shutdownNow():关闭线程池,线程池的状态变为STOP。线程池会尝试中断正在执行的任务,停止处理排队的任务并返回尚未开始执行的任务列表;任务不响应中断时,不能保证立即终止。
isShutDown当调用shutdown()方法后返回为 true。isTerminated当调用shutdown()方法后,并且所有提交的任务完成后返回为 true
FixedThreadPool 被称为可重用固定线程数的线程池。通过 Executors 类中的相关源代码来看一下相关实现:
   /**
     * 创建一个可重用固定数量线程的线程池
     */
    public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory) {
        return new ThreadPoolExecutor(nThreads, nThreads,
                                      0L, TimeUnit.MILLISECONDS,
                                      new LinkedBlockingQueue<Runnable>(),
                                      threadFactory);
    }
另外还有一个 FixedThreadPool 的实现方法,和上面的类似,所以这里不多做阐述:
    public static ExecutorService newFixedThreadPool(int nThreads) {
        return new ThreadPoolExecutor(nThreads, nThreads,
                                      0L, TimeUnit.MILLISECONDS,
                                      new LinkedBlockingQueue<Runnable>());
    }
从上面源代码可以看出新创建的 FixedThreadPool 的 corePoolSize 和 maximumPoolSize 都被设置为 nThreads,这个 nThreads 参数是我们使用的时候自己传递的。
即使 maximumPoolSize 的值比 corePoolSize 大,也至多只会创建 corePoolSize 个线程。这是因为 FixedThreadPool 使用的是容量为 Integer.MAX_VALUE 的 LinkedBlockingQueue(无界队列),队列永远不会被放满。
FixedThreadPool 的 execute() 方法运行示意图(该图片来源:《Java 并发编程的艺术》):

上图说明:
- 如果当前工作线程总数小于
corePoolSize,如果再来新任务的话,就创建新的线程来执行任务; - 当前工作线程总数达到
corePoolSize后,如果再来新任务的话,会将任务加入LinkedBlockingQueue; - 线程池中的线程执行完 手头的任务后,会在循环中反复从
LinkedBlockingQueue中获取任务来执行;
FixedThreadPool 使用无界队列 LinkedBlockingQueue(队列的容量为 Integer.MAX_VALUE)作为线程池的工作队列会对线程池带来如下影响:
- 当线程池中的线程数达到
corePoolSize后,新任务将在无界队列中等待,因此线程池中的线程数不会超过corePoolSize; - 由于使用无界队列时
maximumPoolSize将是一个无效参数,因为不可能存在任务队列满的情况。所以,通过创建FixedThreadPool的源码可以看出创建的FixedThreadPool的corePoolSize和maximumPoolSize被设置为同一个值。 - 由于 1 和 2,使用无界队列时
keepAliveTime将是一个无效参数; - 运行中的
FixedThreadPool(未执行shutdown()或shutdownNow())不会拒绝任务,在任务比较多的时候会导致 OOM(内存溢出)。
SingleThreadExecutor 是只有一个线程的线程池。下面看看SingleThreadExecutor 的实现:
   /**
     *返回只有一个线程的线程池
     */
    public static ExecutorService newSingleThreadExecutor(ThreadFactory threadFactory) {
        return new FinalizableDelegatedExecutorService
            (new ThreadPoolExecutor(1, 1,
                                    0L, TimeUnit.MILLISECONDS,
                                    new LinkedBlockingQueue<Runnable>(),
                                    threadFactory));
    }
public static ExecutorService newSingleThreadExecutor() {
return new FinalizableDelegatedExecutorService
(new ThreadPoolExecutor(1, 1,
0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<Runnable>()));
}从上面源代码可以看出新创建的 SingleThreadExecutor 的 corePoolSize 和 maximumPoolSize 都被设置为 1,其他参数和 FixedThreadPool 相同。
SingleThreadExecutor 的运行示意图(该图片来源:《Java 并发编程的艺术》):

上图说明 :
- 如果当前运行的线程数少于
corePoolSize,则创建一个新的线程执行任务; - 当前线程池中有一个运行的线程后,将任务加入
LinkedBlockingQueue - 线程执行完当前的任务后,会在循环中反复从
LinkedBlockingQueue中获取任务来执行;
SingleThreadExecutor 和 FixedThreadPool 一样,使用的都是容量为 Integer.MAX_VALUE 的 LinkedBlockingQueue(无界队列)。SingleThreadExecutor 使用无界队列作为线程池的工作队列会对线程池带来的影响与 FixedThreadPool 相同。说简单点,就是可能会导致 OOM。
CachedThreadPool 是一个会根据需要创建新线程的线程池。下面通过源码来看看 CachedThreadPool 的实现:
    /**
     * 创建一个线程池,根据需要创建新线程,但会在先前构建的线程可用时重用它。
     */
    public static ExecutorService newCachedThreadPool(ThreadFactory threadFactory) {
        return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                      60L, TimeUnit.SECONDS,
                                      new SynchronousQueue<Runnable>(),
                                      threadFactory);
    }
public static ExecutorService newCachedThreadPool() {
return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
60L, TimeUnit.SECONDS,
new SynchronousQueue<Runnable>());
}CachedThreadPool 的 corePoolSize 被设置为空(0),maximumPoolSize 被设置为 Integer.MAX_VALUE,即它是无界的,这也就意味着如果主线程提交任务的速度高于 maximumPool 中线程处理任务的速度时,CachedThreadPool 会不断创建新的线程。极端情况下,这样会导致耗尽 cpu 和内存资源。
CachedThreadPool 的 execute() 方法的执行示意图(该图片来源:《Java 并发编程的艺术》):

上图说明:
- 首先执行
SynchronousQueue.offer(Runnable task)提交任务到任务队列。如果当前maximumPool中有闲线程正在执行SynchronousQueue.poll(keepAliveTime,TimeUnit.NANOSECONDS),那么主线程执行 offer 操作与空闲线程执行的poll操作配对成功,主线程把任务交给空闲线程执行,execute()方法执行完成,否则执行下面的步骤 2; - 当初始
maximumPool为空,或者maximumPool中没有空闲线程时,将没有线程执行SynchronousQueue.poll(keepAliveTime,TimeUnit.NANOSECONDS)。这种情况下,步骤 1 将失败,此时CachedThreadPool会创建新线程执行任务,execute 方法执行完成;
CachedThreadPool 使用的是同步队列 SynchronousQueue, 允许创建的线程数量为 Integer.MAX_VALUE,可能会创建大量线程,从而导致 OOM。
ScheduledThreadPool 用来在给定的延迟后运行任务或者定期执行任务。这个在实际项目中基本不会被用到,也不推荐使用,大家只需要简单了解一下即可。
public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) {
    return new ScheduledThreadPoolExecutor(corePoolSize);
}
public ScheduledThreadPoolExecutor(int corePoolSize) {
    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
          new DelayedWorkQueue());
}
ScheduledThreadPool 是通过 ScheduledThreadPoolExecutor 创建的,使用的 DelayedWorkQueue(延迟阻塞队列)作为线程池的任务队列。
DelayedWorkQueue 的内部元素并不是按照放入的时间排序,而是会按照延迟的时间长短对任务进行排序,内部采用的是“堆”的数据结构,可以保证每次出队的任务都是当前队列中执行时间最靠前的。DelayedWorkQueue 添加元素满了之后会自动扩容原来容量的 1/2,即永远不会阻塞,最大扩容可达 Integer.MAX_VALUE,所以最多只能创建核心线程数的线程。
ScheduledThreadPoolExecutor 继承了 ThreadPoolExecutor,所以创建 ScheduledThreadExecutor 本质也是创建一个 ThreadPoolExecutor 线程池,只是传入的参数不相同。
public class ScheduledThreadPoolExecutor
        extends ThreadPoolExecutor
implements ScheduledExecutorServiceTimer对系统时钟的变化敏感,ScheduledThreadPoolExecutor不是;Timer只有一个执行线程,因此长时间运行的任务可以延迟其他任务。ScheduledThreadPoolExecutor可以配置任意数量的线程。 此外,如果你想(通过提供ThreadFactory),你可以完全控制创建的线程;- 在
TimerTask中抛出的运行时异常会终止Timer的唯一线程,后续计划任务也无法继续运行。ScheduledThreadPoolExecutor中某个任务抛出异常不会终止其他任务;周期任务抛出异常后,后续执行会被抑制。通过submit()或定时调度方法提交的任务通常会把异常保存在Future中,调用方可通过Future.get()获取;若在afterExecute()中统一检查,也需要从传入的Future中读取异常。
关于定时任务的详细介绍,可以看这篇文章:Java 定时任务详解。
Java 线程池最佳实践这篇文章总结了一些使用线程池的时候应该注意的东西,实际项目使用线程池之前可以看看。